
重新梳理数字电路与计算机体系结构基础,从底层 MOS 管开关特性开始,推导基础门电路拓扑与门延迟现象,并在 Logisim 中完成仿真验证。
1. 电平表示与 MOS 管开关模型
在数字电路中,逻辑 0 与逻辑 1 分别对应物理上的低电平(通常为接地 0V)与高电平(电源电压 VDD)。控制电平切换的基础元件是 MOSFET,在逻辑设计中通常将其抽象为受电压控制的开关。
1.1 nMOS 与 pMOS 的开关特性
MOS 管包含三个端口:Gate(栅极)、Source(源极)、Drain(漏极)。
在 Logisim 中,MOS 管位于 Wiring 元件库下的 Transistor 组件,通过属性面板的 Type 可以在 P-Type 与 N-Type 之间切换:

| 类型 | 导通条件 | 导通特性 | 电气局限 |
|---|---|---|---|
| nMOS | Gate 为高电平 | 漏极与源极导通 | 传低电平无衰减;传高电平时存在阈值电压损失(最高约为 ) |
| pMOS | Gate 为低电平(栅极端带小圆圈) | 漏极与源极导通 | 传高电平无衰减;传低电平时存在阈值电压抬升(最低约为 ) |
由于单一类型的 MOS 管无法在全电压范围内无损传递信号,现代数字电路采用 CMOS 结构:
- 上拉网络:由 pMOS 构成,连接至电源 VDD,负责在输出为 1 时提供稳定的高电平。
- 下拉网络:由 nMOS 构成,连接至地线 GND,负责在输出为 0 时提供稳定的低电平。
在稳态下,上拉网络与下拉网络互斥导通,VDD 与 GND 之间不存在直流通路,因此 CMOS 电路的静态功耗极低。
2. 基础门电路实现
2.1 非门(NOT)
非门(NOT)是结构最简单的 CMOS 单元,由 1 个 pMOS 和 1 个 nMOS 构成。输入信号同时接入两管的 Gate,输出端取自两管相连的漏极:
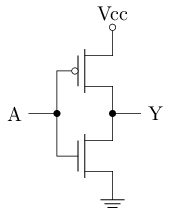
在 Logisim 中搭建并验证两种输入状态下的导通路径:
- 输入为 0(左图):pMOS 导通,nMOS 截止,高电平从电源经 pMOS 传至输出端,输出为 1。
- 输入为 1(右图):pMOS 截止,nMOS 导通,输出端经由 nMOS 连通至地线,输出为 0。

使用 Logisim 窗口顶部的分析电路功能,提取出的真值表:

2.2 与非门(NAND)与 与门(AND)
在 CMOS 工艺中,反相逻辑(NAND、NOR)比同相逻辑(AND、OR)更容易实现。
与非门(NAND)仅由 4 个晶体管构成:
- 上拉网络:2 个 pMOS 并联至电源。只要任一输入为 0,上拉通路即导通输出 1。
- 下拉网络:2 个 nMOS 串联至地线。必须两个输入均为 1,下拉通路才导通输出 0。
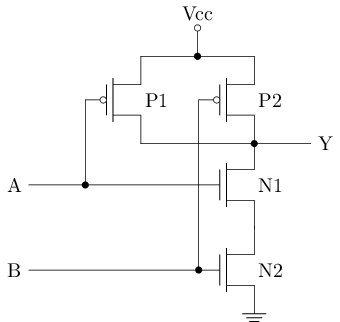
在 Logisim 中搭建与非门并验证真值表:

而与门(AND)并非原生 CMOS 结构,它是在与非门的输出端再级联一个由 1 个 pMOS 和 1 个 nMOS 组成的反相器,共需 6 个晶体管:
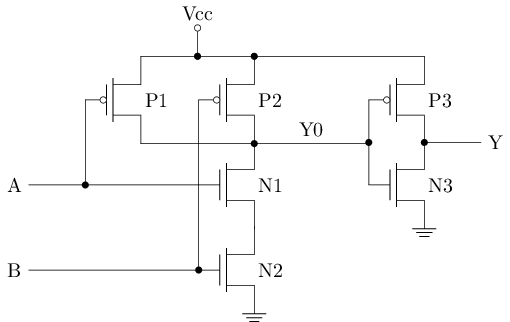
在 Logisim 中搭建与门并验证真值表:

由于与门多了一级反相器,在芯片设计中它的面积大于与非门,并且额外增加了一级门的延迟。
2.3 或非门(NOR)与 或门(OR)
或非门(NOR)与与非门的上下拉网络拓扑刚好对偶,同样只需 4 个晶体管:
- 上拉网络:2 个 pMOS 串联至电源。必须两个输入均为 0,上拉通路才导通输出 1。
- 下拉网络:2 个 nMOS 并联至地线。只要任一输入为 1,下拉通路即导通输出 0。
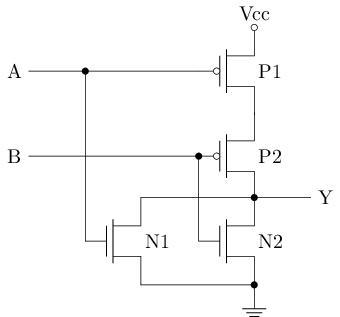
在 Logisim 中搭建或非门并验证真值表:

类似地,硬件中没有原生的或门(OR),它是在或非门的输出端级联一个反相器,共需 6 个晶体管:
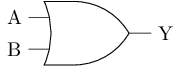
在 Logisim 中搭建或门并验证真值表:

2.4 传输门(Transmission Gate)
传输门(Transmission Gate)由 1 个 nMOS 与 1 个 pMOS 并联构成,由一对互补控制信号驱动:
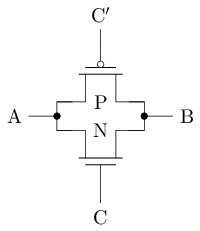
在 Logisim 中搭建传输门并验证其开关特性:

- 控制端 时(导通):下管 nMOS 栅极接高电平导通,上管 pMOS 栅极接取反后的低电平导通。此时输出端 完整跟随输入端 (,),nMOS 负责传递低电平,pMOS 负责传递高电平。
- 控制端 时(截止):两管均截止,输出端呈现高阻态(真值表显示为
-,导线显示为深蓝色悬空状态)。
传输门常用于搭建多路选择器和锁存器,相比使用与或逻辑能显著减少晶体管用量。
2.5 异或门(XOR)
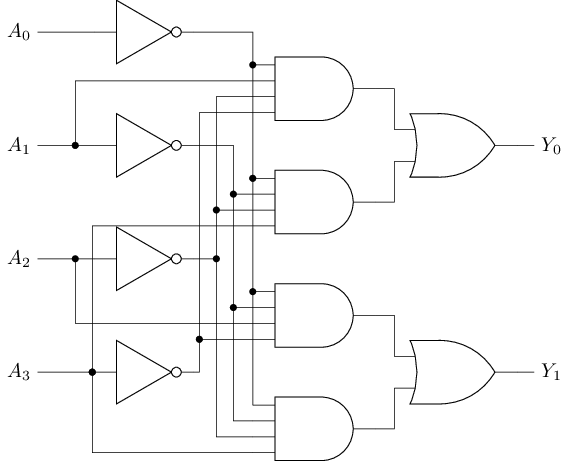
异或门(XOR)的逻辑为输入相异输出 1,相同输出 0()。
门电路级实现方案对比(管数从大到小)
-
标准与或式(22 管):
根据布尔表达式 直接搭建,由 2 个非门、2 个与门和 1 个或门构成:
- 晶体管开销: 个晶体管。
-
OR + NAND + AND 方案(16 管):
根据“至少有一个为 1,但不能两者同时为 1”的定义:,由 1 个或门、1 个与非门和 1 个与门构成:
- 晶体管开销: 个晶体管。
-
双 NOR + AND 方案(14 管):
利用德摩根定律转化:,由 2 个或非门和 1 个与门构成:
- 晶体管开销: 个晶体管。
晶体管级全定制实现(6 管)
在晶体管层次,可以借助反相器和传输门实现极致的面积压缩。ysyx 讲义中的全定制拓扑如下:

在 Logisim 中搭建并验证该全定制电路:

工作原理分析:
- 左侧反相器(P1 + N1):输入信号 ,产生反相信号 。
- 右侧传输门(P3 + N3):受 与 控制:
- 当 ()时,传输门导通,直接将输入端 传递至输出端 (即 )。
- 当 时,传输门截止。
- 中间互补对(P2 + N2):受输入 控制:
- 当 且 时:P2 导通,将 的高电平(1)送至输出端 。
- 当 且 时:N2 导通,将 的低电平(0)送至输出端 。
- 即在 时,。
真值表输出完全符合异或逻辑,而晶体管总数仅为 6 个,相比标准门级方案节省了 70% 以上的器件面积。
3. 门延迟(Propagation Delay)与竞争冒险(Glitch)
在布尔代数中, 恒等于 0。但在物理电路中,信号经过每个门电路都需要一定的物理响应时间,即传播延迟(Propagation Delay)。
若将信号 分为两路接入与门:一路直接相连,另一路经过非门相连。当 由 0 跳变为 1 时:
- 直连路径几乎立即变为 1。
- 非门路径由于门延迟,输出在极短时间内仍然保持原有的 1。
- 在此时间窗口内,与门的两个输入同时为 1,导致输出产生一个极短暂的高电平脉冲()。
这种因路径延迟差异导致的瞬态错误脉冲称为 Glitch(竞争冒险)。
在 Logisim 中可以通过单步模式进行观察:
- 按下
Ctrl+E关闭自动仿真,电路状态被冻结。 - 修改输入信号电平。
- 按下
Ctrl+I单步推进一个门延迟时间步,可以观察到信号沿导线逐步推进、Glitch 产生及消除的完整过程。
4. 组合逻辑电路搭建
4.1 2-4 译码器(Decoder)
译码器的作用是将 位二进制输入(通常代表地址)转换为 位独热码(One-hot)输出。输入值为几,对应索引的输出位为 1,其余位全为 0。在处理器架构中,译码器常用于寻址和寄存器选通。
对于 2 位输入 与 4 位输出 ,输出每一位的逻辑表达式为:
电路需要 2 个非门(4 管)与 4 个两输入与门(24 管),共消耗 28 个晶体管。可以看出,译码器的输出端数量和与门规模随输入位宽呈 指数增长。
在 Logisim 中使用 Wiring -> Splitter(分线器)进行总线分流与汇聚搭建该电路:

- 输入端通过
Splitter将 2 位总线 拆解为独立的第 0 位与第 1 位。 - 经过 2 个反相器与 4 个与门生成 4 路单线输出。
- 输出端再次通过
Splitter将 4 路单线重新汇聚为 4 位总线 。 - 通过分析电路工具验证,真值表输出严格满足独热码特征(
00->0001,01->0010,10->0100,11->1000)。
走线优化:配置门电路输入的极性(Negate)
在基础实现中,我们需要在输入端额外放置反相器来拉出反相信号线。在 Logisim 中,逻辑门元件原生支持配置输入端的极性:
- 选中与门,在属性面板中配置对应引脚为取反极性(端点会出现小圆圈)。
- 这样输入母线可以直接直连各与门,省略了外部反相器器件,不仅逻辑等价,画布走线也更加规整清晰:

该电路可直接封装为子电路(Subcircuit),作为后续复杂模块的基础单元。
4.2 译码器的扩展:从 2-4 到 3-8 译码器
如果要用两个 2-4 译码器级联拼装成 3-8 译码器,必须引入使能端(Enable,EN)。否则两个 2-4 译码器同时工作,输出会同时出现两个 1,破坏独热码约束。
带使能控制的 2-4 译码器封装
为了不改动 2-4 译码器内部的与门引脚数,可以利用 Logisim 支持多位宽逻辑门的特性:
- 保持内部原本的
decoder_2to4不变; - 在 4 位输出总线上串接一个 4 位宽的与门;
- 1 位使能信号
EN经由Wiring -> Bit Extender(符号扩展)扩充为 4 位,与译码结果做按位与:EN = 1时:4 位译码结果正常输出;EN = 0时:输出被强制钳位为全 0(禁用)。

3-8 译码器的级联组装
拥有使能端后,将 3 位输入 进行分工:
- 低两位 同时连入两个
decode_2to4_en子模块的输入端; - 最高位 作为片选信号(Chip Select):反相后接入低位子模块的
EN,直连接入高位子模块的EN; - 两组 4 位输出总线经
Splitter汇聚为 8 位总线 。

分析电路真值表显示,从 000 到 111,8 位输出中的 1 从最低位依次移至最高位,完全符合 3-8 独热码规范。
扩展思考:真实 CMOS 芯片中的使能实现(Power Gating)
在上述逻辑设计中,失能是通过与门将输出逻辑电平置 0 来实现的。而在现代集成电路的物理设计中,使能控制还可以进一步下沉到晶体管层面:
- 在下拉 nMOS 网络与地线(GND)之间串联一个共用的总开关管(通常称为 Sleep Transistor 或 Foot Switch):
- 当
EN = 1时,总开关闭合,整个模块接地正常工作; - 当
EN = 0时,总开关断开,不仅逻辑输出失能,还直接切断了静态漏电通路,达到超低功耗关断(Power Gating)的效果。
- 当
4.3 七段数码管译码器(7-Segment Decoder)
七段数码管由 7 个条形发光二极管(标记为 a 到 g)按“8”字型排列,另附 1 个小数点发光二极管(h)。七段数码管译码器的功能是将 4 位二进制输入解析为驱动各段亮灭的控制信号。
ysyx 讲义对该电路提出了明确的规范约束:
- 当输入为 0 到 9 时:正常点亮对应数字,小数点 h 保持熄灭;
- 当输入超出十进制范围(10 到 15 /
0xA到0xF)时:显示段 a 到 g 全部熄灭,仅点亮小数点 h。
为了避免直接针对 4 位输入列写庞大复杂的组合逻辑,采用两级架构设计:
- 第一级:调用之前封装的 4-16 译码器(
decoder_4to16),将 4 位输入展开为 16 根独热码信号线(0 到 15)。 - 第二级:采用矩阵式(PLA 风格)布线,设置 8 个或门分别对应 a 到 h 共 8 个控制端。各段所需点亮的独热码线引出节点汇入对应或门。

电路验证现象:
- 当前测试输入为
1000(十进制 8)时,第 8 根独热码线导通,通过矩阵节点驱动 a 到 g 七个或门全部输出高电平,红色发光管全亮显示出数字“8”,而右下角的小数点 h 保持熄灭。 - 当输入处于 10 到 15 范围时,总线将 10 到 15 六根信号导向底部的 h 或门,输出高电平点亮右下角小数点,满足“超出范围仅显示小数点”的规范要求。
扩展:支持十六进制显示(0 到 F)
讲义随后的任务要求扩展该译码器,使其在输入 10 到 15 时不再仅显示小数点,而是分别显示十六进制字符 A、b、C、d、E、F。为了避免字符形态与数字 8 和 0 混淆,其中 B 与 D 约定采用小写形式显示。
在此版本中:
- 移除了仅用于指示超出范围的小数点 h 段,保留 a 到 g 七个主要段;
- 10 到 15 这 6 根独热码线分别接入对应字符所需点亮段的或门:
- 10(A):点亮 a, b, c, e, f, g
- 11(b):点亮 c, d, e, f, g
- 12(C):点亮 a, d, e, f
- 13(d):点亮 b, c, d, e, g
- 14(E):点亮 a, d, e, f, g
- 15(F):点亮 a, e, f, g
- 输出端连接至按标准“8”字形排列的发光组件:

为了版面规整,每个或门的输入端均统一对齐为 16 通道交叉阵列(Crossbar),右侧驱动走线也进行了对称收束。测试输入为 1010(十进制 10)时,第 10 根独热码线导通,驱动 a、b、c、e、f、g 段全部点亮,唯独底横 d 段熄灭,在数码管上清晰呈现出大写字母 A。当输入切换为其他数值时,十六进制字符亦能准确显示。
4.4 编码器(Encoder)与未定义输入处理
编码器是译码器的逆过程,用于将独热码输入还原为对应的二进制数值。例如在 4-2 编码器中,4 位输入 应对应 2 位输出 :
0001(第 0 位有效)输出000010(第 1 位有效)输出010100(第 2 位有效)输出101000(第 3 位有效)输出11
在实际设计中,如何处理非独热码的非法输入决定了硬件开销的巨大差异:
方案一:严格独热码检查(严格与或结构)
为了保证“只有合法的独热码才产生有效编码,其余输入一律置 0”,使用 4 输入与门配合输入端取反极性严格匹配每一路独热码:

- 现象:只有
0001、0010、0100、1000产生对应的二进制输出,一旦输入包含多个 1(如0110)或全 0,输出全部被与门拦截置为00。 - 开销:需要 3 个四输入与门与 2 个或门,等效晶体管开销达 120 个左右,规模随输入位宽急剧膨胀。
方案二:利用无关项(Don’t Care)化简的极简结构
如果引入设计约定——“调用者必须保证输入严格为独热码,其余非法输入视为无关项 X”,布尔逻辑可大幅化简:
- 只需在第 1 或第 3 位为 1 时拉高:
- 只需在第 2 或第 3 位为 1 时拉高:
此时整个电路仅需 2 个简单的两输入或门:

- 现象:在合法独热码输入下功能完全正确,且仅消耗 16 个晶体管(较方案一节省近 90% 面积)。但如果输入出现多路 1(例如按键冲突输入
0110),真值表显示输出会被错误计算为11。
这种对非法输入的无能为力,直接促成了**优先编码器(Priority Encoder)**的诞生:允许输入端同时有多个 1,由硬件按优先级自动裁决并编码最高位的 1。
4.5 4-2 优先编码器(Priority Encoder)
优先编码器用于解决多路信号同时触发时的仲裁问题,其规则是:当输入中出现多个 1 时,永远仅对最高有效位(优先级最高)进行编码输出。在计算机体系结构中,该结构是中断控制器(Interrupt Controller)进行多设备请求仲裁的物理基础。
逻辑推导
设定输入 中 拥有最高优先级, 优先级最低:
- 若最高位 ,无论低位为何值,输出必须为
11; - 仅当 且 时,第 2 位才能胜出输出
10(条件项为 ); - 仅当 且 且 时,第 1 位才能胜出输出
01(条件项为 ); - 若仅 或全 0,输出为
00。
根据上述条件,输出两位的布尔逻辑为:
电路搭建与仿真
在 Logisim 中,继续利用输入端取反极性来精简布线:

- 电路结构:仅需 1 个三输入与门、1 个两输入与门和 2 个或门。由于 的有效状态对应输出
00,且其本身不具备压制任何高位的能力,因此 在门级网络中甚至无需物理连线即可满足真值表要求。 - 真值表特征:右侧分析表格完整展现了优先编码器的阶梯屏蔽效果:只要 (第 8 到 15 行),无论低三位如何组合,输出一律恒为
11;当 且 (第 4 到 7 行),输出一律恒为10。各输入组合均严格按最高优先级导通。
4.6 多路选择器(MUX)
多路选择器是处理器数据通路中核心的控制枢纽,本质是硬件中的条件选择分支。它根据选择端 的电平状态,从多路输入数据中择一路由至输出端 。
以 1 位 2 选 1 选择器(2-1 MUX)为例,其基础功能定义为:
- 当 时:输出
- 当 时:输出
在实现层面,讲义给出了标准门电路与传输门全定制两种方案,两者的器件开销与面积存在显著差距:
方案一:标准门电路实现(与或结构,26 管)
布尔表达式为 。使用 1 个非门生成互补选择信号,分别门控两路数据输入,最后通过或门汇聚:
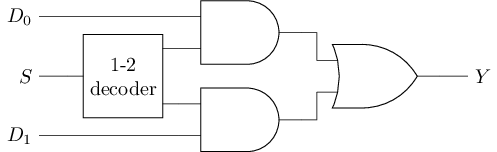
在 Logisim 中搭建并验证:

- 硬件开销:包含 1 个非门(2 管)、2 个与门(12 管)和 1 个或门(6 管),等效消耗约 20 到 26 个晶体管。
- 实测真值表:当 时,前 4 行输出完全跟随输入 ;当 时,后 4 行输出完全跟随输入 。
方案二:传输门全定制实现(仅 6 管)
利用传输门作为双向无损模拟开关的特性,可以直接控制数据路径的物理通断:
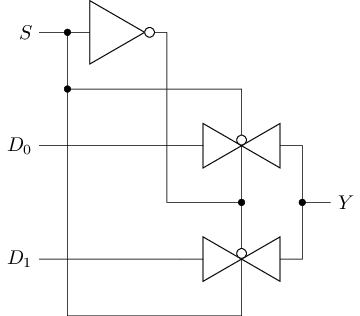
在 Logisim 中搭建并验证:

- 工作机制:
- 由 1 个反相器将选择信号 反相产生 ;
- 上方传输门(连接输入 )由 控制:当 ()时导通,将 送至输出端 ;
- 下方传输门(连接输入 )由 控制:当 ()时导通,将 送至输出端 ;
- 两路传输门互斥导通,确保任意时刻仅有一路数据驱动输出端。
- 开销优势:仅需 1 个反相器(2 管)+ 2 个传输门(4 管)= 共 6 个晶体管,相比门级方案面积缩小了近 80%,实测真值表与门级方案完全等价。
扩展:3 位 4 选 1 选择器(传输门二叉树拓扑)
在真实的处理器设计中,数据通路通常具有多位位宽(如 8 位、16 位、32 位),并且常需要在多路来源间进行选择(如 ALU 运算源选择、寄存器写回来源选择)。
针对讲义要求的 3 位 4 选 1 选择器,采用两级二叉树结构(MUX Tree)进行搭建:
- 两级二叉树拓扑:
- 第一级(左侧):由低位选择信号 及其反相信号并行控制两组 MUX。上半区负责在输入 A(
001)与输入 B(010)之间抉择;下半区负责在输入 C(110)与输入 D(111)之间抉择,各自输出一组 3 位中间总线。 - 第二级(右侧):由高位选择信号 及其反相信号控制最终的 MUX,在两组中间总线之间完成最终裁决。
- 第一级(左侧):由低位选择信号 及其反相信号并行控制两组 MUX。上半区负责在输入 A(
- 总线通道实现:每一位数据均独立分配一个互补传输门,通过
Splitter进行 3 位总线的分线与汇聚。

- 硬件开销评估:整个 3 位 4 选 1 电路仅包含 2 个 CMOS 反相器(4 管)+ 第一级 12 个传输门(24 管)+ 第二级 6 个传输门(12 管)= 仅消耗 40 个晶体管。若采用门电路方案(2-4 译码器 + 3 组四输入与或门),晶体管开销将超过 130 个。
- 实测验证:当前选择信号置为
11(选择通道 D):- 第一级下半区传输门导通,选出输入 D(
111); - 第二级下半区传输门导通,将该 3 位数据送至输出端 Y;
- 最终输出端准确输出
111,绿色导通路径完整展示了从输入到输出的物理连通轨迹。
- 第一级下半区传输门导通,选出输入 D(
4.7 比较器(Comparator)
比较器用于判断两个多位二进制数据是否全等,在处理器体系结构中主要负责条件分支跳转指令(如 RISC-V 的 beq / bne)的相等性裁决。
逻辑推导与电路拓扑
两数完全相等意味着每一位对应数值完全一致:
- 单比特判等:使用同或门(XNOR)。当且仅当两位取值相同时(同为 0 或同为 1),输出 1;
- 全等聚合:将每一位同或门的输出汇总接入一个多输入与门。当且仅当每一位全部匹配时,与门输出 1。
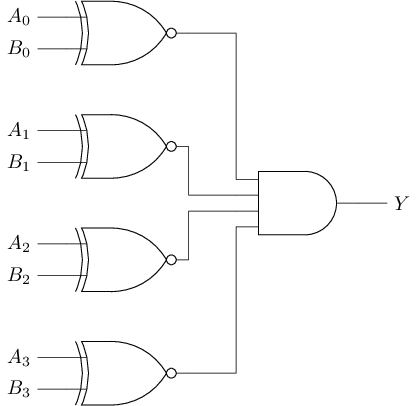
硬件开销评估
- 4 位比较器:4 个同或门( 管)+ 1 个四输入与门(24 管)= 48 个晶体管;
- 32 位比较器:32 个同或门与 32 输入与门(多级与门级联),开销线性扩展至约 440 个晶体管。
Logisim 搭建与仿真
方案一:XNOR + AND 结构(同或逐位判等)
布尔表达式为 :

- 两路输入总线经
Splitter分离后,第 0 到 3 位分别接入 4 个 XNOR 门的输入端; - 测试两组输入均置为
0110(十进制 6):由于各位数值完全相同,4 个 XNOR 输出全部为高电平 1; - 后级四输入与门导通,输出端准确输出高电平 1。若任意一位出现差异,对应 XNOR 输出跌落为 0,与门即翻转为 0。
方案二:XOR + NOR 结构(异或求异 + 或非归零)
利用德摩根定律,判等逻辑可转化为对偶结构:

- 工作机制:前级改用 4 个异或门(XOR)检测差异——若某一位不同则输出 1,完全相同则输出 0;后级接入一个 4 输入或非门(NOR4)。
- 实测验证:输入同为
0110时,4 个 XOR 门全部输出暗绿色低电平 0;四输入或非门在全 0 输入下输出高电平 1。 - 工艺优势:在 CMOS 物理设计中,NOR 是原生反相逻辑单元(4 管下拉并联),相比需要后级反相的与门(AND = NAND + NOT),该对偶方案不仅门延迟更小,晶体管开销也更低。
4.8 加法器(Adder):从半加器到全加器
加法是计算机算术逻辑单元(ALU)的基石。在电路实现上,多位加法器由底层的全加器级联构成,而全加器又可由最基础的半加器拼装而成。
1 位半加器(Half Adder)
半加器用于计算两个 1 位二进制数的加法,不考虑低位传入的进位信号。
- 逻辑定义:
- 本位和 (异或运算)
- 进位输出 (与逻辑)
- 电路复用设计:在具体搭建时,可以直接复用前面方案三的双 NOR + AND 异或门结构。由于该异或结构内部天然包含一个计算 的与门,因此进位端 可以直接从该与门节点引出,无需额外增加任何门电路器件:

- 实测验证:当前输入置为 ,本位和 输出 0,进位端 输出 1,完整代表二进制结果
10(十进制 2)。右侧 4 行真值表与算术相加规则完全吻合。
1 位全加器(Full Adder)
全加器引入了低位进位输入 ,用于计算 3 个单比特的算术和(),输出本位和 与向高位的进位输出 。
ysyx 讲义要求通过级联半加器的方式实现全加器:
- 两级半加器与进位汇聚拓扑:
- 第一级半加器完成 ,输出中间和 与中间进位 ;
- 第二级半加器接收 与低位进位输入 ,输出最终本位和 与第二级进位 ;
- 最终进位输出为 。由于两级半加器不可能同时产生进位,因此直接使用一个末级或门将两路进位汇聚即可。

- 实测验证:当前输入置为三输入全高的极限情况 :
- 第一级半加器输出中间和 0、中间进位 1;
- 第二级半加器接收中间和 0 与 ,输出最终本位和 ;
- 末级或门汇聚第一级进位,输出最终进位 ;
- 输出 ,代表二进制数值
11(十进制 3)。右侧分析电路导出的 8 行真值表完整满足多位二进制加法进位规则。
4 位行波进位加法器(Ripple-Carry Adder, RCA)
为了计算多位二进制加法,将多个 1 位全加器串行级联,低位的进位输出 直接驱动相邻高位的进位输入 。进位信号如波浪般自最低位向最高位逐级传递,因此称为行波进位加法器(RCA)。
在 Logisim 中实例化 4 个 full_adder_1bit 子电路进行搭建:

- 电路拓扑:
- 两路 4 位输入总线 与 经
Splitter拆解为单线,分别送入 4 个全加器对应的 与 端口; - 最低位全加器接收外部进位输入 ;
- 进位链依次串联:第 0 位 第 1 位 第 2 位 第 3 位 ;
- 最高位进位输出作为整组加法器的 ,各级全加器的和信号 经由右侧
Splitter汇聚为 4 位总线 。
- 两路 4 位输入总线 与 经
- 实测验证:
- 测试输入设定为带有进位的典型用例:(十进制 14)、(十进制 6)、(十进制 1);
- 理论运算值:;
- 实测输出端:4 位和总线 精准输出
0101(5),高位进位端 准确输出1(权值为 16),合成结果严格等于 21。
- 性能与时序瓶颈:
- 行波进位加法器的关键路径(Critical Path)由进位链决定。当位宽为 时,最高位必须等待前 级进位依次结算完成才能获得稳定输出,运算延迟与位宽成正比()。在高性能处理器设计中,为了打破该延迟链条,通常会采用超前进位加法器(Carry-Lookahead Adder, CLA)。
4.9 补码原理与加减法一体化电路
在计算机硬件设计中,无需为减法单独开辟减法器硬件电路。利用二进制补码的数学性质,减法运算 可以等价转化为加法:
根据补码定义,负数 的补码表示为其按位取反加 1(即 )。代入可得:
利用该恒等式,只需在加法器的基础上增加极少控制逻辑,即可实现“加减法一体化”:
- 操作数取反选择:使用一个多路选择器 MUX(或异或门)受控于模式选择信号
sub。当sub = 0(加法模式)时透传原码 ;当sub = 1(减法模式)时透传取反后的 ; - 末位补 1:将控制信号
sub直接接入加法器最低位的进位输入端 。在减法模式下,sub = 1自动将最低位进位拉高,完成最后的 操作。
在 Logisim 中使用 4 位 2-1 MUX 搭建加减法一体化电路:

实测减法运算:
- 输入设置:被减数 (十进制 14),减数 (十进制 6),控制信号
sub = 1(启动减法模式); - 运算推导:
截断第 4 位进位(,权重为 16)后,低 4 位结果为 8(
1000_b); - 实测输出:和总线 精准输出
1000(十进制 8), 输出 1(在无符号数减法中 表示无借位,即 ),完全验证了 的硬件计算正确性。
4.10 补码溢出检测(Overflow Detection)
4 位有符号补码的数值表示范围为 。当运算结果超出该区间时,即发生溢出(Overflow),导致符号位错乱。
数学定义到硬件逻辑的映射推导
数学上判断溢出的规则为“同号相加产生异号结果”(正正得负或负负得正,异号相加绝不溢出)。
若直接根据符号位搭建判断电路: 该逻辑开销较大。而在硬件实现中,考察最高位(符号位)全加器的物理进位关系:
- 本位和:
- 进位输出:
将三类符号输入情况代入分析:
- 异号相加():此时 且 ,代入可得 ,恒有 (绝不溢出);
- 同为正数():进位输出必定 ,且 。正正得负的溢出条件为 ,即充要条件为 。此时 ;
- 同为负数():进位输出必定 ,且 。负负得正的溢出条件为 ,即充要条件为 。此时 。
综合可知,溢出的充分必要条件可极简表示为最高位的进位输入与进位输出异或:
其物理本质在于: 是低位数值区向符号位灌入的进位,而 是符号位自身向外排出的进位。当两者不一致时(仅进不出或仅出不进),符号位必然被非法改写。
电路搭建与实测
在 4 位加减法器的最高位全加器旁,引出进位输入 与进位输出 接入 1 个异或门:

实测用例分析:
- 设定输入:两组 4 位有符号正数加法,(十进制 ),(十进制 ),控制信号
sub = 0(加法模式); - 理论运算值:。由于数值 已经超出了 4 位有符号补码的表示上限 ,必然引发正溢出;
- 实际输出结果:4 位和总线 输出
1011_b(符号位被错误篡改为 1,在补码中被解释为 ),呈现出“正正得负”的异常; - 溢出检测逻辑响应:此时低位数值区向符号位灌入进位 ,而符号位本身并无进位排出()。异或门计算 ,输出端
Overflow精准输出高电平1,成功捕获并告警了该溢出事件。
(待更新:时序逻辑电路)